> For the complete documentation index, see [llms.txt](https://vida03.gitbook.io/redteam/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://vida03.gitbook.io/redteam/web/ruby-regex-authentication-bypass.md).
# Ruby: regex authentication bypass
## Introdução
Vamos começar analisando o ambiente que iremos atacar:
Esse código irá verificar se a entrada do usuário não possui caracteres especiais, os caracteres permitidos são: **caracteres numéricos** e **letras**
Se digitarmos outro valor por exemplo "**<**" a aplicação irá retornar "Malicious Input Detected".
Após entender o comportamento da aplicação precisamos bypassar esse filtro pra conseguirmos obter SSTI (pressumi que seria isso por estar usando um sistema de templates)
## Bypass Time
Em regex o ^ e $ indicam respectivamente início e fim de linha, ou seja, esa expressão regular está verificando o início e fim de cada linha, então se uma linha for suficiente conseguimos bypassar o filtro, podemos utilizar o **\n** para isso, para explorar podemos utilizar o **Burp** ou o **curl**
Com o **Burp** eu tive que acrescenter um **\n** para conseguir bypassar, depois vi outras soluções na internet e vi que com o curl conseguimos explorar apenas com um **\n**, vamos ver os dois exemplos
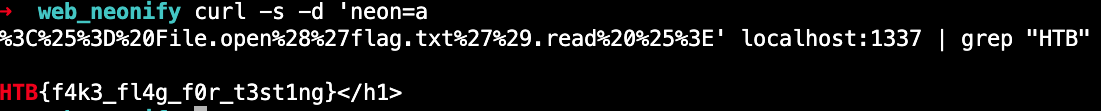
Agora vamos ver o exemplo com o curl:
Podemos copiar o **\n** do Burp e colar na linha de comando do curl
## **Considerações**
Esse ataque é exclusivo (até onde eu testei) do ruby, para conseguirmos o mesmo resultado em outras linguagens precisaria de outras opções no filtro, por exemplo em python se pareceria com isso:
```
if re.match(r'^[0-9a-z]+$', my_input, re.MULTILINE):
print('Matches...')
```
## Links de apoio
{% embed url="" %}
{% embed url="" %}